Lab
Avec ou sans mémoire : ce que mesure une évaluation Embedded
Réponse courte
Une IA peut connaître les faits d’une situation sans connaître la décision prise par l’équipe. Pour mesurer l’effet de ce contexte manquant, Nawame et Tsuno ont comparé des réponses à des questions identiques, avec plusieurs façons d’accéder à la mémoire. Le résultat est encourageant ; sa portée dépend du protocole.
Comparer l’accès au contexte
L’expérience ne demandait pas quel modèle était le plus intelligent. Elle cherchait à savoir si des décisions et des raisons correctement retrouvées amélioraient une réponse métier.
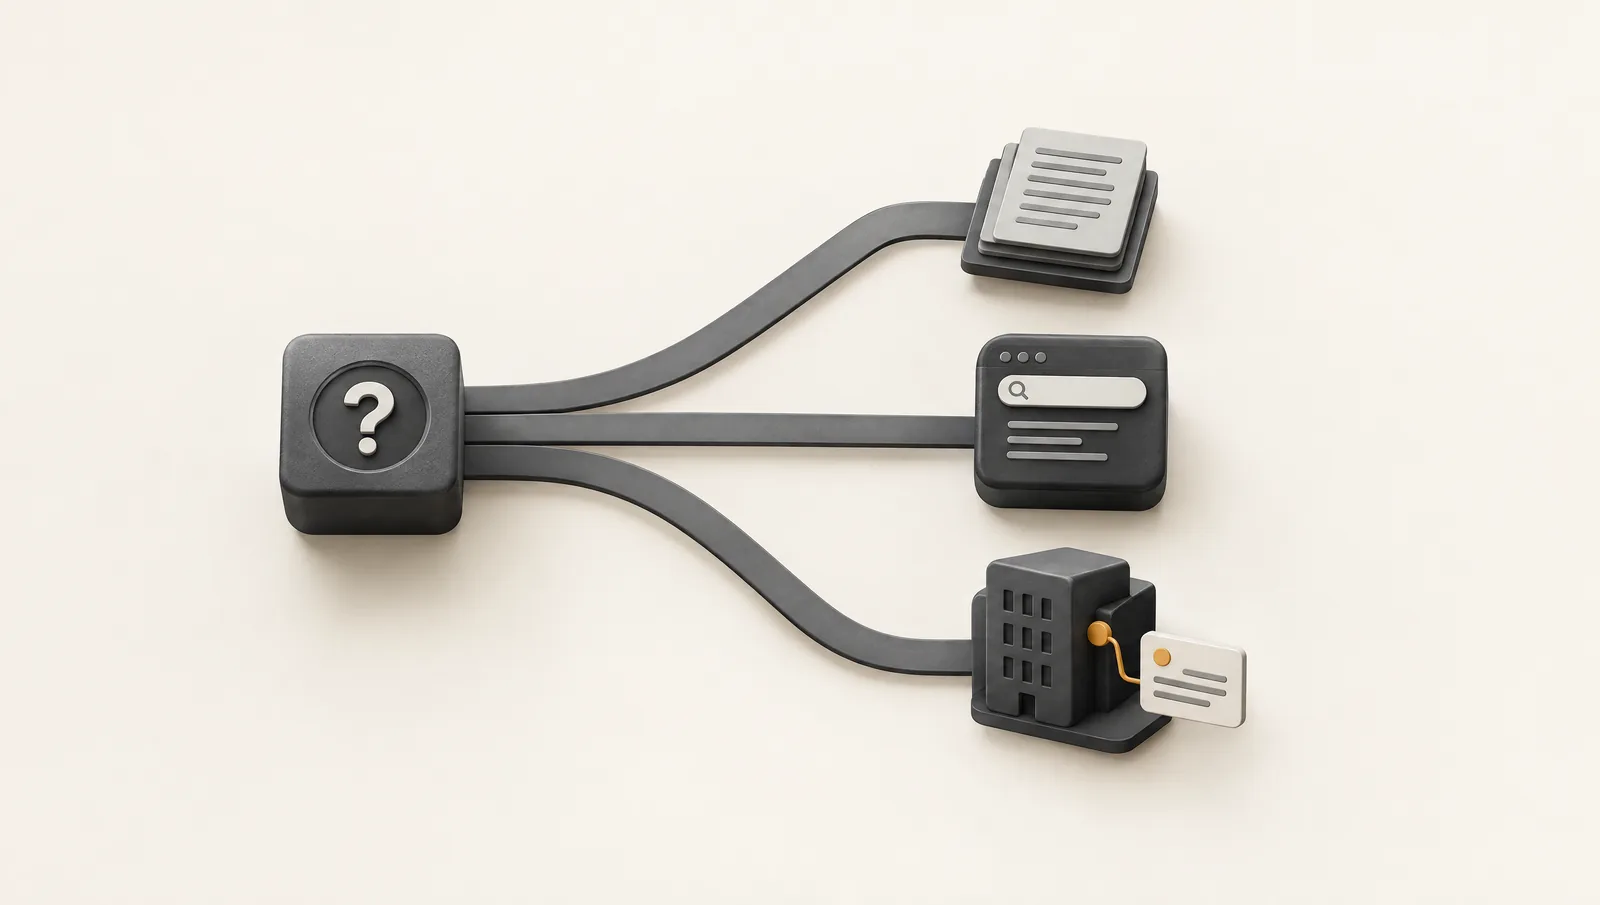
Trois configurations recevaient les mêmes questions. La première disposait des faits opérationnels seuls. La deuxième ajoutait une recherche plein texte dans la mémoire, suivie de la lecture des premiers résultats. La troisième recevait une lecture par objet, avec la qualification et les dates des mémoires concernées.
Cette deuxième configuration est importante : la comparaison porte sur une recherche générique définie par le protocole. Elle ne démontre pas une supériorité sur tous les moteurs de recherche, tous les systèmes RAG ou toutes les stratégies de récupération.
Des résultats sur un corpus neuf
Après une première campagne, une seconde a utilisé douze nouveaux scénarios synthétiques et trente-six questions. Le contexte était assemblé par le code produit contre un environnement de recette Nawame, plutôt qu’inséré manuellement dans chaque question.
Deux familles de modèles ont répondu, avec une température fixée à zéro. L’exactitude mesurait la présence des éléments attendus : décision, raison, condition ou date selon la question. Ce score ne signifie donc pas que toute propriété de chaque réponse était parfaite.
| Répondant | Faits seuls | Recherche générique | Lecture par objet |
|---|---|---|---|
| Qwen3.8-Flash | 35,6 % | 63,4 % | 100 % |
| Llama 3.3 70B | 30,6 % | 63,4 % | 100 % |
Dans ces conditions, le contexte rattaché à l’objet améliore fortement la restitution des décisions attendues. Les cas incluaient notamment des décisions expirées ou remplacées et des contextes absents ou interdits.
Évaluer aussi la mesure
Un score automatique peut se tromper. Lors de la seconde campagne, le critère préinscrit « pas davantage d’hallucinations avec la mémoire » n’a pas été atteint pour Llama selon la notation brute : deux réponses sur trente-six étaient signalées, contre une sans mémoire.
La relecture a montré que les deux réponses avec mémoire citaient une ancienne décision en la présentant comme remplacée. Le repérage par expressions avait détecté l’ancien contenu sans comprendre suffisamment son statut. Le résultat brut reste une limite publiée ; l’audit explique pourquoi il ne correspondait pas à une invention réelle.
La première campagne avait révélé un autre problème : le juge chargé d’évaluer l’utilité ne recevait pas toutes les dates que les réponses pouvaient légitimement citer. Compléter son dossier a permis un diagnostic, puis la seconde campagne a repris la mesure sur un corpus neuf avec un dossier complet. Cette fois, l’utilité jugée de la lecture par objet dépassait celle de la recherche générique pour les deux modèles.
Ce que l’expérience permet de conclure : portée et limites
Le travail soutient une hypothèse précise : retrouver le contexte d’un objet, avec ses conditions et son statut, peut aider un assistant à restituer une décision historique. Il montre aussi qu’une évaluation doit vérifier ses propres instruments.
Il ne mesure ni un gain de temps chez des clients, ni une économie, ni une réduction d’incidents. Le corpus a été rédigé par l’équipe du chantier ; chaque question n’a reçu qu’une mesure par configuration. Une évaluation indépendante et un usage réel pourraient révéler d’autres difficultés.
La suite logique consiste à mesurer les bonnes réponses avec leur coût humain : contexte effectivement disponible, explications compréhensibles et corrections possibles. C’est le lien entre la mémoire attachée aux objets métier et la collecte mesurée des explications.
À lire aussi : Comment mesurer si une mémoire évite réellement du travail refait et Comment tester une mémoire IA sans tricher avec le benchmark.