Lab
Choisir un moteur d’embeddings sur des mesures comparables
Réponse courte
Un serveur avec des processeurs dédiés n’est pas automatiquement le plus rapide pour un moteur d’embeddings. Le Lab Nawame a comparé plusieurs machines sur une charge précise. L’enseignement principal tient autant aux conditions de mesure qu’au classement obtenu.
Le calcul qui peut ralentir la recherche
Un embedding représente un texte sous forme de vecteur afin de permettre des comparaisons de proximité. Produire ces vecteurs consomme du calcul, notamment lors de l’indexation de documents longs.
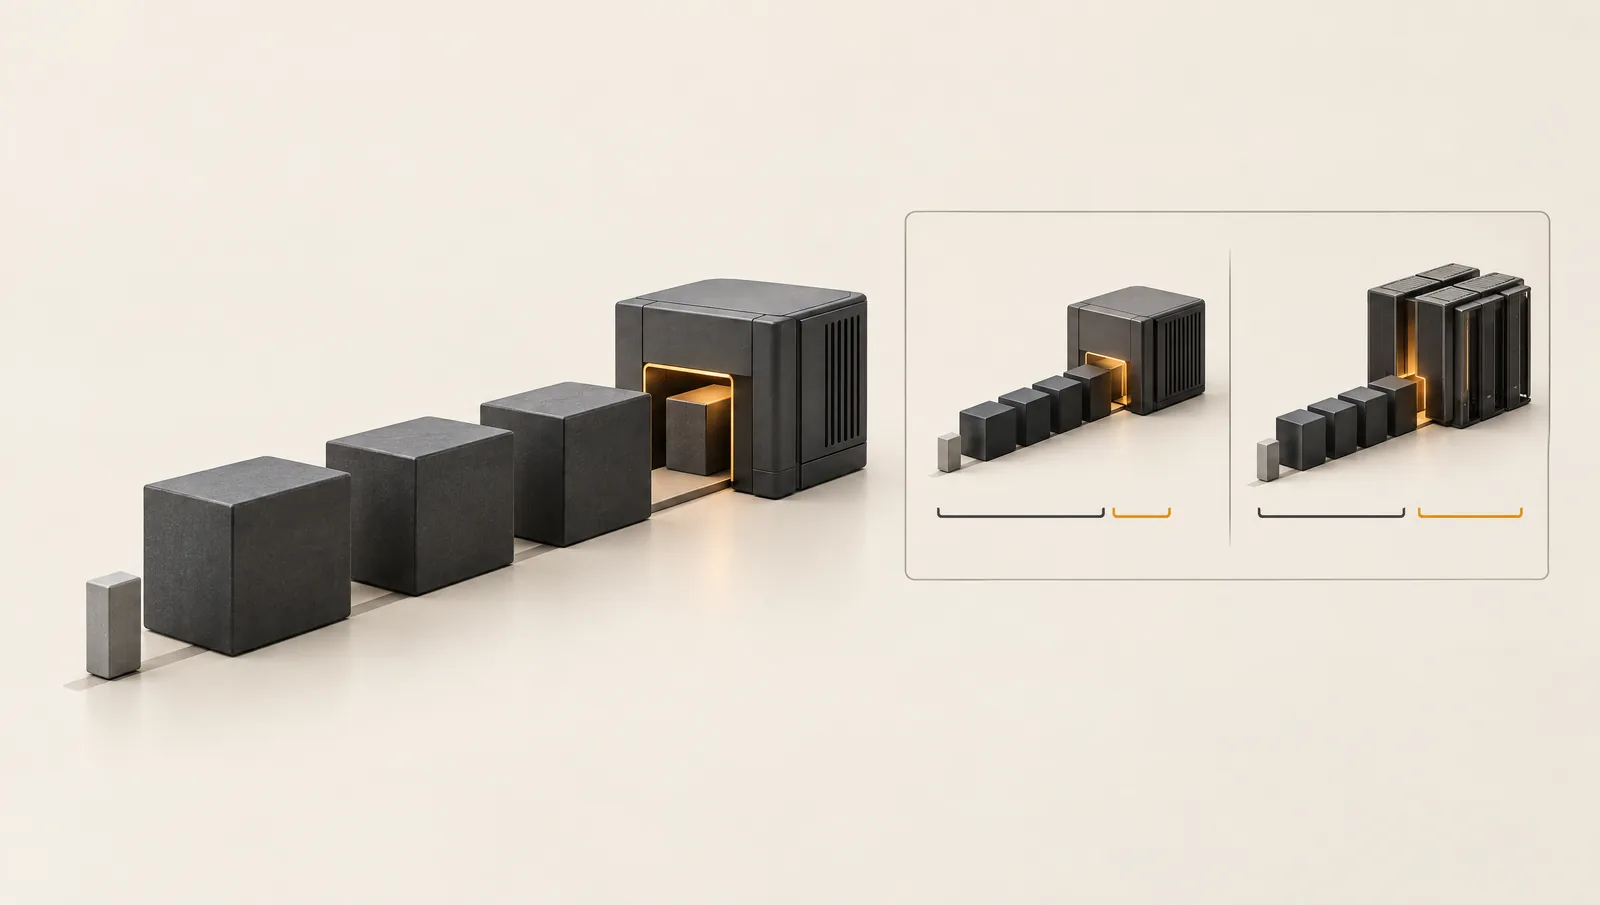
Si une requête courte attend derrière plusieurs morceaux en cours de traitement, son expérience réelle dépend de la file d’attente. Le temps de calcul au repos ne suffit donc pas à décrire le service rendu pendant des écritures.
Isoler les traitements lourds de la base de données permet d’étudier cette concurrence plus clairement et d’éviter de faire porter les mêmes variations de charge à toutes les fonctions. Ce choix doit néanmoins être évalué avec son coût d’exploitation et ses frontières de confiance.
Comparer une charge définie
Le banc du 20 octobre 2026 utilisait le même moteur d’embeddings, les mêmes poids de modèle et les mêmes paramètres sur les machines comparées. Les textes étaient synthétiques. Plusieurs longueurs permettaient de distinguer la requête courte du morceau documentaire plus coûteux.
Le CPX42 disposait de huit processeurs virtuels partagés sur une architecture AMD EPYC Genoa. Le CCX23 disposait de quatre processeurs virtuels dédiés sur une architecture Milan. Le nombre de ressources, la génération du processeur et les instructions disponibles différaient : le banc compare donc des configurations complètes.
Pour les morceaux de 2 900 caractères, la médiane séquentielle mesurée était de 914 millisecondes sur le CPX42, contre 2 166 millisecondes sur le CCX23. Ce résultat concerne une opération de calcul sur ce banc. Il ne mesure pas le temps complet d’une recherche Nawame.
Ne pas aligner des chiffres incompatibles : portée et limites
La machine candidate pouvait être chargée plus fortement. Les machines servant la production ont été préservées : mesures séquentielles légères et pauses entre les appels. Les résultats sous concurrence publiés pour ces dernières étaient des extrapolations, pas des essais équivalents.
Présenter tous les chiffres comme un match à conditions identiques effacerait cette différence essentielle. La comparaison séquentielle informe un choix ; elle ne suffit pas à promettre un avantage fixe sous toutes les charges.
Le banc montre aussi que la simultanéité ne multiplie pas automatiquement le débit. Quand le calcul utilise déjà fortement les ressources, davantage de demandes peuvent surtout allonger la file d’attente. Une requête courte rapide au repos peut alors attendre bien davantage.
Ce que signifie « partagé »
Aucun vol de CPU n’a été observé sur le CPX42 pendant la fenêtre de charge étudiée. Cette observation ne devient pas une garantie permanente. Une offre partagée dépend aussi de son environnement et peut évoluer.
Le choix d’une machine doit donc s’accompagner d’une surveillance de la régularité, du débit, des erreurs et des conditions matérielles. Le mot « dédié » ne remplace pas une mesure ; le bon résultat ponctuel d’une machine partagée ne remplace pas non plus l’observation dans la durée.
Les écarts numériques entre vecteurs ont également été contrôlés. Il faut vérifier la cohérence des représentations avant d’attribuer un gain à une simple accélération.
Un moteur commun à Nawame
Cette recherche concerne le moteur commun utilisé par les fonctions de mémoire et de contexte de Nawame, y compris Embedded. Elle ne décrit pas une infrastructure conçue pour Embedded seul.
Le meilleur calcul reste parfois celui que l’on évite. Réutiliser les morceaux inchangés réduit la pression sur la file sans rendre chaque opération individuelle plus rapide. Le choix matériel et la réduction du travail inutile répondent donc à deux questions complémentaires.
La résilience et le coût complet permettent ensuite d’évaluer le service au-delà de ce banc. La mémoire intégrée aux logiciels donne un exemple des usages qui dépendent de ce moteur commun.
À lire aussi : Limites du retrieval à grande échelle et Pourquoi nous publions aussi les limites de Nawame.