Lab
Limites du retrieval à grande échelle
Réponse courte
Quand une base grossit, la recherche ramène plus de passages proches sans être justes : quasi-doublons, versions périmées, contradictions. Les réponses peuvent donc se dégrader alors que rien n’a changé dans le système. Le filtrage (par projet, période, statut, droits) et un contenu bien rangé et daté aident plus que le simple fait d’ajouter des données.
Une équipe monte un assistant qui répond à partir de ses documents internes. Au début, une petite base, des réponses plutôt bonnes, tout le monde est content. Deux ans plus tard, la base a beaucoup grossi et les réponses sont devenues moins nettes. Personne n’a touché au système. C’est le contenu qui a changé de nature.
C’est l’un des pièges les plus contre-intuitifs de la récupération d’information : ajouter des données ne rend pas toujours les réponses meilleures, et peut les rendre moins bonnes. Cet article explique les mécanismes en termes simples, sans chiffres et sans détails de fabrication, puis ce que vous pouvez faire de votre côté.
Rappel et précision, en deux images
Deux mots reviennent tout le temps. Le rappel mesure, parmi tout ce qui était pertinent, la part que la recherche a réussi à retrouver. La précision mesure, parmi ce qu’elle a ramené, la part qui est vraiment pertinente.
Imaginez deux bibliothécaires. Le premier revient avec les bras chargés de livres : il a probablement le bon, mais il est noyé parmi les autres (bon rappel, précision faible). La seconde revient avec un seul livre : si c’est le bon, c’est parfait, sinon vous n’avez rien (précision élevée, rappel fragile).
Aucun réglage ne donne les deux à la perfection. On choisit un compromis, et la taille de la base le déplace : plus il y a de matière, plus il est difficile d’être à la fois complet et net.
Les embeddings rapprochent des sens, pas des identités
Un embedding est une représentation numérique d’un texte, construite pour que des textes de sens voisin soient proches. C’est ce qui permet de chercher « rembourser un client » et de tomber sur « procédure de remboursement », sans que les mots soient les mêmes.
Mais proche en sens ne veut pas dire identique. « Nous reportons le lancement » et « nous maintenons le lancement » parlent de la même chose et disent le contraire. Une négation, une date, un nom propre, un numéro de version pèsent peu dans la proximité de sens, alors qu’ils changent tout pour vous.
C’est la mécanique derrière le cas que nous décrivons dans l’article sur le faux précédent en recherche sémantique : deux situations qui se ressemblent sans être comparables.
Lexical, sémantique, hybride
La recherche lexicale compare des mots. Elle est excellente pour les noms exacts, les références, les codes, les termes rares. Elle est sourde aux reformulations : si vous cherchez « annuler » et que le document dit « résilier », elle passe à côté.
La recherche sémantique compare des sens. Elle rattrape les reformulations, mais elle est moins fiable pour les identifiants exacts et pour les nuances fines.
Une recherche hybride combine les deux, et c’est souvent une bonne idée dans les grandes lignes. Elle ne supprime pas le problème : il faut encore décider comment fusionner les deux listes de résultats, et cela ajoute ses propres erreurs. Pour la différence entre récupération, base vectorielle et mémoire, voir mémoire IA vs RAG.
Pourquoi plus de documents peut donner de moins bonnes réponses
Quatre mécanismes jouent ensemble quand la base grossit.
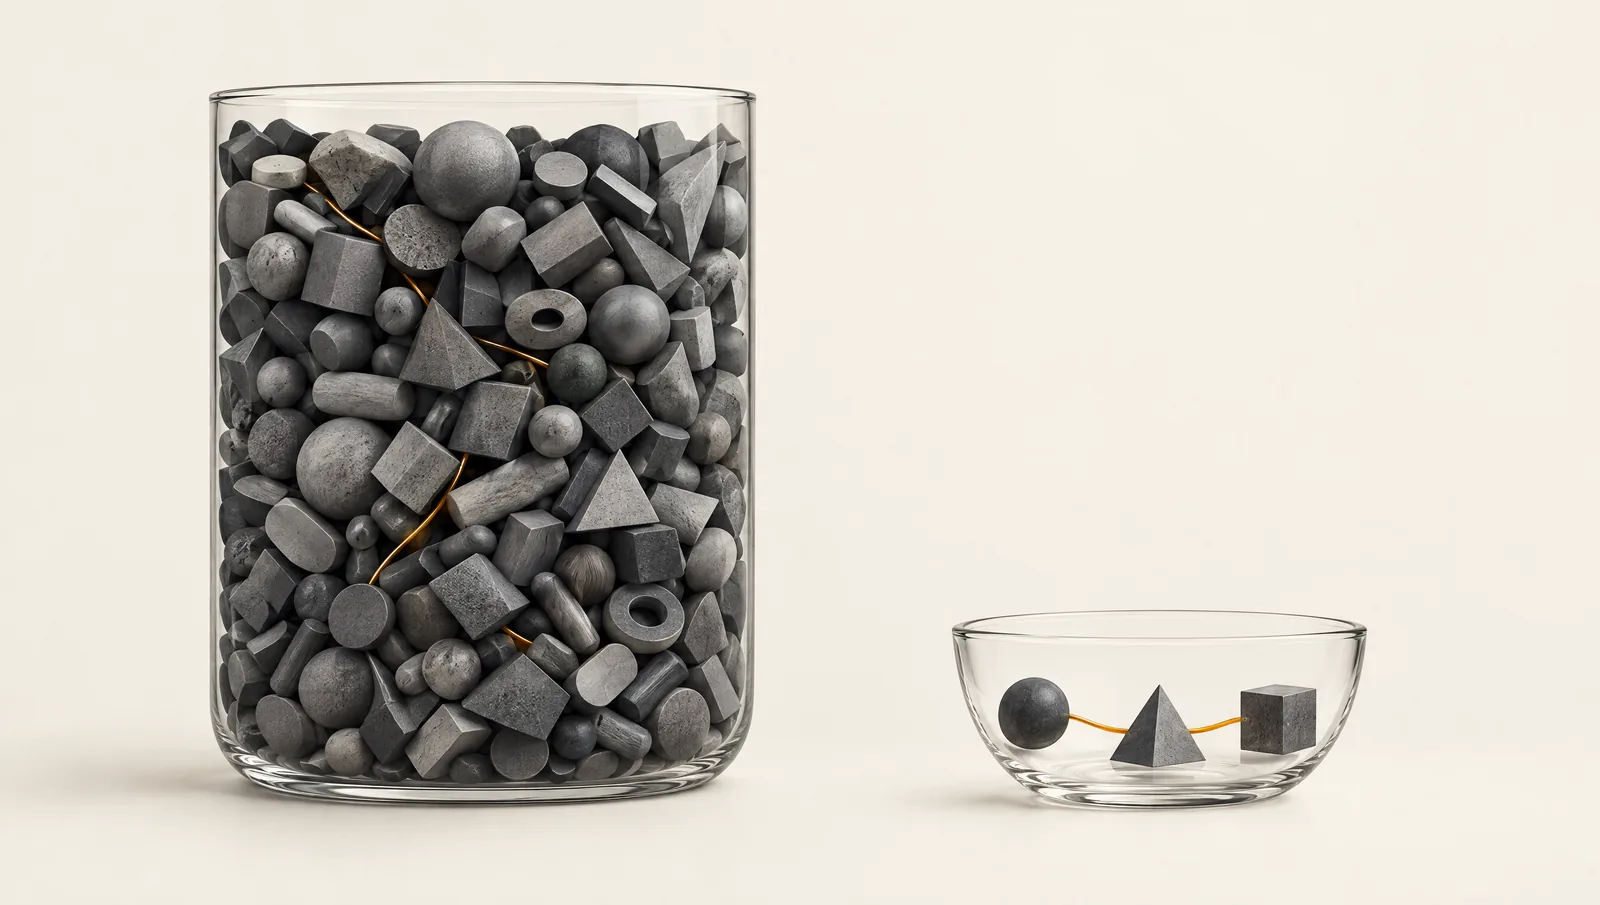
Les quasi-doublons. Une base qui vit accumule des versions d’un même document, des copies, des brouillons. Pour une question donnée, les premiers résultats se remplissent de passages presque identiques, et l’élément différent qui comptait est repoussé plus bas, là où personne ne le lit.
Le bruit. Plus il y a de documents, plus il y a de passages qui ressemblent vaguement à n’importe quelle question. La chance d’en trouver un qui paraît plausible et qui est faux augmente avec le volume.
La fraîcheur. Pour la proximité de sens, un texte vieux de trois ans est aussi proche de la question que celui d’hier. Sans date prise en compte, rien ne le met derrière.
Les contradictions. Deux versions d’un même fait se retrouvent côte à côte, et le modèle qui reçoit les deux n’a pas de moyen sûr de savoir laquelle est en vigueur.
Un exemple fictif. Une équipe de support a dans sa base la procédure de remboursement de 2022, celle de 2024 et un brouillon de la suivante. La question « comment rembourse-t-on un abonnement annuel ? » ramène trois passages presque identiques, dont deux périmés. La réponse mélange les étapes. Aucun des trois documents n’est faux en soi : c’est leur cohabitation qui l’est.
Le même risque existe côté prompt quand on colle trop de matière : nous le traitons dans prompt géant ou contexte ciblé.
Classement, latence et coût : ce qui grossit avec la base
Quand la recherche trouve beaucoup de candidats, l’ordre compte plus que tout : seuls quelques passages peuvent être donnés au modèle, donc ce qui est classé en dessous n’existe pas pour lui. Le classement (ranking) est l’étape qui décide de cet ordre, et la qualité des réponses dépend beaucoup de lui. Comment un système donné classe ses résultats est justement ce qui le distingue des autres, et chez Nawame nous ne publions pas ce détail.
La latence et le coût suivent la même pente, dans les grandes lignes : plus il y a de contenu, plus il faut de travail pour l’indexer, le mettre à jour et le parcourir. Quand un document change, son index doit être refait. Le plus gênant n’est pas là : un système lent se voit tout de suite, alors qu’un système qui répond vite et à côté se remarque beaucoup plus tard.
Le filtrage change tout
La façon la plus efficace de garder de bonnes réponses sur une grande base est de réduire la zone de recherche avant de chercher par le sens. Un filtre retire d’un coup des milliers de candidats qui n’auraient jamais dû être en concurrence :
- par projet ou par client : on ne cherche que dans le bon périmètre ;
- par période : on écarte ce qui date d’avant un changement ;
- par statut : on ne cherche que dans ce qui est décidé ou de référence, pas dans les brouillons ;
- par droits : on ne cherche que dans ce que la personne a le droit de voir.
Le revers est qu’un filtre suppose des étiquettes. Quelqu’un doit avoir dit à quel projet appartient un texte, quand il date, quel est son statut. Sans ce travail, le filtre n’a rien à filtrer.
Côté Nawame, une IA ne reçoit que ce que Nawame est autorisé à renvoyer pour votre compte, et une clé peut être restreinte à une organisation ou à un dossier. Cela borne ce que l’IA peut voir, cela ne dit pas si ce qui est retrouvé est vrai : c’est tout le sujet de pourquoi retrouvé ne veut pas dire vrai.
Ce que vous pouvez faire côté utilisateur
Beaucoup de gains se font sans outil sophistiqué, par hygiène de contenu :
- Ranger : un sujet, un périmètre. Mélanger deux clients dans le même espace, c’est fabriquer de la confusion.
- Dater : mettez la date dans le texte même, pas seulement dans le nom du fichier.
- Remplacer plutôt qu’ajouter : quand une décision en remplace une autre, marquez l’ancienne comme remplacée au lieu de laisser les deux au même niveau.
- Nommer exactement : écrivez le nom du client, la référence, le numéro de version. Les mots exacts aident la partie lexicale.
- Supprimer les quasi-doublons : garder dix copies d’un document, c’est garantir que neuf passent devant autre chose.
- Une idée par note : un passage qui mélange trois sujets ressemble un peu à tout et ne répond bien à rien.
Les limites actuelles
Nawame ne résout pas ces problèmes. Soyons précis sur ce qui reste.
- Proximité de sens n’est pas identité : un rapprochement reste une piste à vérifier, et les restitutions de Nawame distinguent un « précédent retrouvé » d’un « rapprochement possible » pour cette raison.
- Une contradiction que personne n’a consignée ne peut pas être signalée.
- Un élément utile peut être manqué. Aucune recherche ne garantit d’avoir tout retrouvé.
- La qualité dépend de ce qu’on écrit : une mémoire mal tenue donnera de mauvaises restitutions, à grande échelle comme à petite.
- Une confidentialité renforcée peut réduire ce que le serveur peut traiter, donc certaines fonctions.
Nous ne donnons aucun chiffre dans cet article. Un chiffre sans protocole ni jeu de test serait trompeur, et les protocoles sont plus utiles que les scores.
Un test à faire sur votre propre corpus
Avant de décider qu’un système de recherche « marche », testez-le sur vos données, à la main :
- Écrivez une vingtaine de questions dont vous connaissez la bonne réponse.
- Ajoutez des questions dont la réponse a changé avec le temps, pour voir si l’ancienne passe devant.
- Ajoutez des questions sans réponse dans la base, pour voir si le système invente plutôt que d’admettre un vide. Nous détaillons l’idée dans tester les sujets qui n’existent pas.
- Pour chaque question, notez si le bon passage est revenu (rappel) et combien de passages inutiles l’accompagnaient (précision).
- Refaites le test quand la base a beaucoup grossi.
Si les résultats se dégradent avec le volume, vous savez où agir : filtrer, dater, remplacer, dédoublonner. Nous expliquons comment nous classons les erreurs d’une mémoire dans comment nous mesurons les erreurs de mémoire, et le Lab rassemble nos méthodes.